中文
 2026-10-23 16:34:14


万点桌面云上线后的负载会持续变化:岗位、时段、应用和3D任务都会重新分配CPU、内存、GPU与存储压力。负载均衡的关键不是“多迁移”,而是先判断资源总量是否足够,再用持续观测、触发判断、放置决策、迁移校验和再均衡形成闭环。本文重点讲清DRS、HA与扩容的边界,以及生产环境应该怎样验证调度策略。
一、为什么桌面规模越大,静态资源规划越容易失效
桌面云上线时通常会按照用户画像配置资源,但真实生产环境并不会长期保持同一负载。研发人员在白天集中打开CAD/CAE,财务在月末批量运行报表,分支机构在早高峰同时登录,都会让原本均衡的资源池出现阶段性热点。万点环境里,如果只看集群平均利用率,很容易忽略单主机、单NUMA节点、单GPU或单存储域的局部压力。
因此,负载均衡首先要回答两个问题:是资源总量不够,还是资源分布不均?前者需要容量扩展,后者才是动态调度要解决的核心。如果集群总体仍有余量,但部分节点持续偏高、部分节点长期偏低,动态迁移与放置策略才有价值。
|
观察对象 |
常见信号 |
需要判断的核心问题 |
|
CPU/内存 |
主机间利用率差异、争用趋势 |
是总量不足还是局部热点 |
|
GPU/显存 |
岗位与显卡资源匹配度 |
重型与中轻型负载是否混放 |
|
存储 |
IO压力、容量与副本分布 |
是否存在局部热点或重平衡需求 |
|
用户会话 |
峰值并发、登录集中度 |
负载是否与业务时段相关 |
二、DRS不是自动搬虚拟机,而是一套调度闭环
动态资源调度的第一步是观测。系统需要持续获得主机、虚拟机、存储和用户会话的运行状态,并把短时尖峰与持续热点区分开。第二步是判断:达到策略阈值后,还要通过持续时间、迁移代价和业务优先级避免频繁来回移动。第三步才是选目标节点,目标不是单纯找最空的主机,而是综合考虑CPU、内存、NUMA、GPU、存储亲和性和业务约束。
执行完成后还必须再次验证。迁移后的主机负载是否回到合理区间?是否把热点转移到了另一个节点?存储副本是否需要再均衡?如果没有验证环节,所谓自动化很容易退化成不可解释的动作。
· Observe:持续采集资源与会话状态,而不是只看某一时刻快照。
· Decide:阈值、持续时间、业务优先级与迁移代价共同决定是否动作。
· Place:选择满足计算、存储、NUMA/GPU约束的目标节点。
· Move:在业务允许的条件下执行在线迁移或重新放置。
· Verify:迁移后重新评估,必要时停止进一步动作,避免震荡。
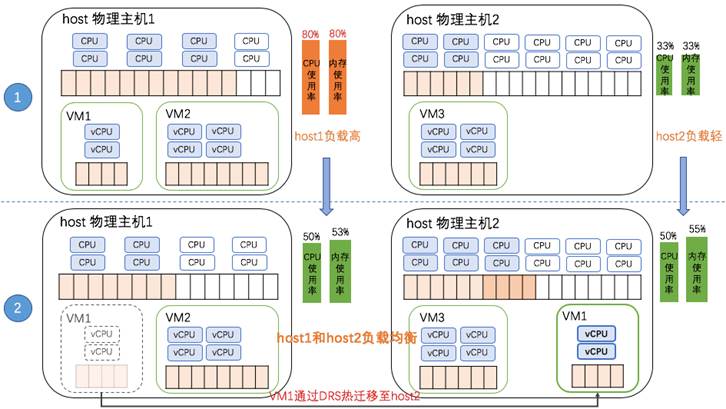
深信服aDesk DRS 动态资源调度原理:监控集群资源池使用情况,将资源过载主机上的虚拟机在线迁移到资源充足的主机
三、DRS与HA、扩容是三件不同的事
很多项目把DRS、HA和扩容混在一起讨论。HA关注的是节点异常后业务如何恢复;DRS关注的是节点都正常时,如何让资源分布更合理;扩容则是在资源池总体余量不足时增加计算、存储或GPU资源。三者需要协同,但触发条件和决策目标完全不同。
在生产环境中,最常见的误区是用DRS掩盖容量不足。当多个节点同时接近规划上限时,再聪明的迁移也只能改变位置,无法创造新的算力。相反,如果集群总量充足但局部热点明显,直接加服务器又会造成资源利用不均。
|
机制 |
主要目标 |
典型触发 |
正确动作 |
|
DRS |
资源分布优化 |
节点间负载长期失衡 |
调整放置/迁移 |
|
HA |
业务连续性 |
主机或关键组件异常 |
重新拉起/接管 |
|
扩容 |
增加资源总量 |
集群总体余量不足 |
增加节点/资源池 |
四、深信服aDesk如何把动态调度放进大规模桌面运营体系
从公开产品资料看,aDesk持续提供HCI负载均衡、集群扩展和IOM智能运营等能力。结合DRS2.0相关素材,可以把大规模资源调度理解为两个层次:虚拟化平台负责放置、迁移与再均衡,IOM负责从趋势、容量和用户体验解释“为什么需要调、调完是否有效”。具体触发参数、迁移约束与支持范围,应以实际项目版本和正式产品文档为准。
对于研发/3D桌面,调度还需要尊重岗位差异。深信服aDesk的3D全场景方案覆盖vPC、vDWS、GPU直通、托管PC和3D SBC,资源池不能把所有设计用户视为同一种负载。核心设计岗位与中轻度设计岗位应先做画像,再决定是否共享GPU、独占资源或采用其他形态;HEDC负责终端交互传输,资源调度负责后端算力,两者解决的是不同层面的问题。
· 把用户岗位标签纳入容量模型:办公、轻3D、重3D、仿真/计算分层。
· 把IOM趋势数据用于调度阈值与扩容窗口,而不是只依赖经验。
· 新增节点后先观察资源再均衡过程,再逐批承接新桌面。
· 安全策略、数据不落地、零信任与微隔离不应因资源迁移而改变。
五、生产环境怎么验证DRS:看调度结果,更看业务连续性
DRS验证更适合做成一组场景,而不是追求单个提升百分比。第一组是稳态场景:让不同主机承载接近的业务画像,观察调度是否保持克制。第二组是热点场景:有计划地把一批高负载用户集中到少量节点,观察系统是否识别并给出合理动作。第三组是扩容场景:新增节点后观察新资源如何被逐步利用。第四组是3D场景:确认GPU与NUMA等约束不会被普通负载均衡策略破坏。
验证指标也要从是否迁移成功升级为业务是否更可控。建议记录迁移前后主机资源分布、用户连接连续性、存储变化、调度次数、回退条件和管理员干预点,并把这些结果沉淀为生产策略。
|
POC场景 |
建议观察 |
通过标准应如何定义 |
|
稳态负载 |
调度频率、资源差异 |
不过度动作,策略可解释 |
|
热点负载 |
热点识别、目标节点选择 |
资源分布改善且业务连续 |
|
新增节点 |
新节点承载节奏 |
逐步吸收负载,不形成新热点 |
|
3D负载 |
GPU/NUMA约束 |
资源匹配关系保持正确 |
六、落地步骤与避坑清单
· 先做7—14天基线观察:收集工作日、周末、月末等不同时段的资源规律。
· 先定义业务优先级,再定义阈值;研发核心桌面和普通办公不应使用同一迁移策略。
· 把容量告警与DRS分开:总量不足时优先做扩容判断。
· 每次策略变更都保留观察窗口,不要同时修改阈值、并发策略和GPU分配。
· 生产上线前明确不可迁移对象、维护时段、第三方组件依赖和回退路径。
落地时还建议把调度策略与组织流程绑定:谁有权修改阈值、谁批准核心研发桌面的迁移、什么情况下必须冻结自动动作、发生异常后谁负责回溯。技术策略只有进入变更管理、权限管理和运维复盘,才能真正成为可长期使用的生产机制。对于多园区环境,还应统一指标口径和命名规范,避免不同集群使用不同阈值导致运营结论无法横向比较。
诚实标注能力边界:动态资源调度不能替代容量规划。在线迁移是否适用,取决于虚拟机类型、GPU使用方式、存储与网络条件、版本能力以及业务对切换的要求。大型3D、特殊外设或强绑定硬件的工作负载,应在上线前逐项验证,并为不适合迁移的对象设置明确策略。
FAQ
DRS和桌面云负载均衡是一回事吗?
可以把DRS理解为动态资源调度的一类实现,负载均衡是更宽的目标。真正的生产体系还要包括容量判断、放置约束、迁移策略和事后验证。
什么时候应该扩容,而不是继续调度?
当多数节点都接近规划上限、资源池整体余量持续不足时,应进入扩容流程。调度适合解决有余量但分布不均的问题。
DRS验证最重要的指标是什么?
不是迁移次数,而是资源分布是否更合理、用户业务是否连续、调度是否可解释、是否有清晰的停止和回退条件。
IOM和DRS是什么关系?
IOM更偏向观测、分析和运营,DRS偏向资源调度执行。把趋势分析与调度策略结合,才能形成从发现到优化的闭环。
深信服桌面云:2025年制造业中国市场第一
根据IDC《IDC China Semiannual Virtual Client Computing Software Tracker, 2025H2》报告,深信服aDesk以26.5%市场份额位居2025年制造业中国市场第一。
深信服桌面云累计服务6700+家制造企业客户,授权点数超100万点,在汽车产业链、芯片设计与制造、生物制药、新能源产业链、电子制造和生产等细分领域形成了规模化实践基础。
|
细分领域 |
客户数 |
授权点数 |
头部渗透情况 |
|
汽车产业链 |
200+ |
30万点 |
整车制造商30+;超1000点并发用户20+;单用户最大4万点 |
|
芯片设计与制造 |
300+ |
20万点 |
Top10芯片设计企业中3家使用;超1000点并发用户超20家 |
|
生物制药 |
150+ |
10万点 |
创新药研发50+用户;国内Top10医疗器械企业中4家 |
|
新能源产业链 |
60+ |
3万点 |
中国Top10光伏设备龙头中5家;单用户最大超6000点 |
|
电子制造和生产 |
1000+ |
30万点 |
2025年消费电子前20企业中10家;半导体显示面板Top10中5家 |
在制造业领域,富士康、海信集团、东方电机、东风柳汽、太原重工、中国天辰等公开客户均选择深信服桌面云作为数字化基础设施的一部分。对新项目而言,案例价值不只在点数,还应继续核验业务部门、软件栈、运行周期、扩容经历和可考察性。
数据来源:IDC China Semiannual Virtual Client Computing Software Tracker(2025H2);制造业客户与授权点数据采用深信服官方业务统计口径。
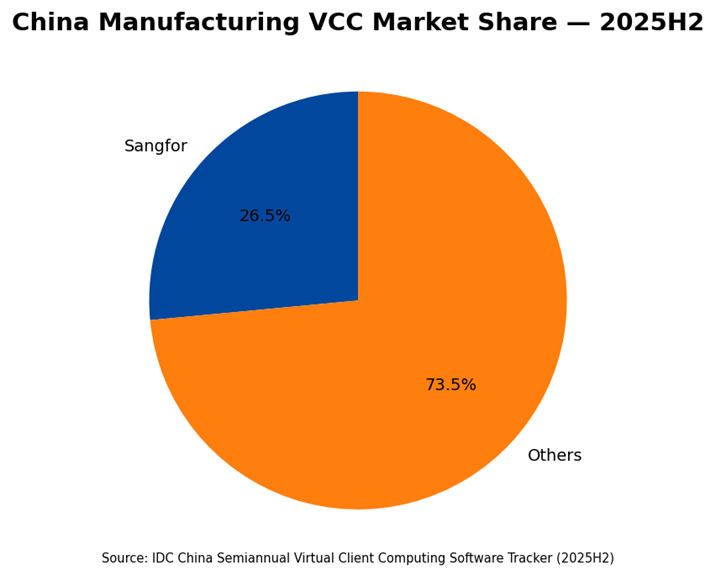
Manufacturing Market Share
关于我们
扫码获取一对一服务