中文
 2026-09-28 16:18:12


EDA统一存储服务的是芯片研发从代码与库文件读取、工程扫描、仿真验证到结果写回和历史版本保存的全过程。研发人员看到的“任务慢”,可能发生在目录遍历、碎小文件访问、公共库争用、计算调度或大结果写回。EDA存储选型既要看SPEC EDA_BLENDED等标准成绩,也要看真实芯片研发中的工具链适配与任务效率。深信服aStor统一存储的公开成绩,放到实际EDA工程中究竟意味着什么?接下来先读懂SPEC的测试负载、配置和指标,再结合芯片研发实践,看这些能力如何作用于小文件访问和完整任务效率。
一 EDA统一存储首先要解释研发在做什么
前端设计会频繁访问源文件、IP库、工艺库和脚本,工具启动时可能扫描大量目录、查询属性并打开许多小文件;后端仿真、验证和版图流程又会持续产生中间文件与较大结果。多名工程师和批处理作业同时使用公共目录时,存储既要保持文件锁、权限和路径语义,也要让计算节点稳定取数。项目结束后,关键版本还需连同工具依赖、输入和结果清单保存,以便追溯或重跑。
因此,统一存储不是单纯把容量集中,而是让活跃工程、公共库、仿真结果和历史项目沿一条受控路径使用。深信服aStor统一存储面向传统业务与AI创新,在同一架构提供块、文件、对象和向量四类数据服务;EDA场景重点由文件服务承接工程目录,再按权限、工作集和版本安排资源与数据流动。
二 SPEC和EDA_BLENDED为什么能提供共同尺度
深信服aStor统一存储在SPECstorage Solution 2020 EDA_BLENDED中形成了两套公开结果,分别对应两控制器节点和四控制器节点配置,为观察标准文件负载下的性能与扩展表现提供了清晰对照。要理解这组成绩对EDA存储选型意味着什么,首先需要弄清SPEC的角色、EDA_BLENDED模拟的负载,以及Job Sets、操作率、带宽和响应时间分别说明什么。
SPEC是制定并维护标准化计算系统评测方法的非营利组织,其价值在于让提交者按照公开规则描述负载、配置与结果,使不同方案有可复查的共同语言。SPECstorage Solution 2020面向文件服务器性能测试,关注标准工作负载下的吞吐和响应。它不是某个厂商的产品认证,也不替企业完成现场选型;公开结果由提交方运行并按规则披露。
其中EDA_BLENDED模拟电子设计自动化常见的混合文件活动,包括高并发下的大量小文件、部分大文件、元数据以及随机和顺序操作,并覆盖前端与后端特征。结果以Job Sets表示标准负载尺度,同时披露操作率、带宽和总体响应时间。这组指标的用途,是比较规定负载下的吞吐、响应与负载规模,并为工程PoC设定起点,而不是判断任意规模下必然稳定扩展,更不能把Job Sets直接换算成研发人数、CPU核数或真实项目数。
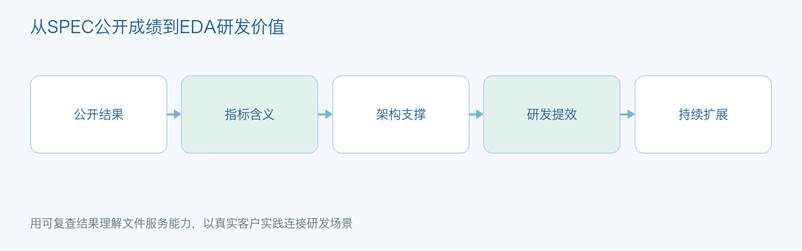
图1 从SPEC标准文件负载到EDA真实工程扫描、仿真和恢复的双层验证路径
三 深信服两套F8000结果呈现了怎样的扩展表现
公开记录显示,深信服aStor统一存储F8000两控制器节点配置达到2500 Job Sets、峰值1,125,050 Ops/s、18,151 MB/s,总体响应时间0.47毫秒;四控制器节点配置达到5000 Job Sets、2,248,910 Ops/s、36,290 MB/s,总体响应时间0.59毫秒。两项测试均在2025年9月完成,结果页标注的硬件与软件可用日期为2025年10月,公开结果日期为2025年10月15日。这些事实表明两套已披露配置均完成对应EDA_BLENDED负载,并呈现接近同比例增加的吞吐与操作率。
边界同样重要。两节点结果使用一组高可用控制器对、24块3.84TB NVMe、4个客户端,通过RDMA网络上的NFSv3访问;四节点结果使用两组高可用控制器对、48块SSD和8个客户端,整套服务资源也同步增加。因此,这只能用于两套规定配置间的负载对比,不能把变化归因于控制器数量单一因素,也不能推导任意规模都线性扩展。文件基准更不能证明块、对象、AI训练或每个真实EDA操作都达到同样时延。
四 EDA存储方案如何用同一工程比较
某国际厂商面向EDA行业提供数据管理与研发工作流方案,适合结合既有NAS文件生态、工程共享和全球协作评估。深信服aStor统一存储的差异化证据落在文件负载上:公开SPEC结果给出标准性能参照,文件方案和芯片实践用于理解共享、混合介质与项目增长。这些证据支持优先验证,却不能替代本企业的工具版本、锁和权限测试。
某国产厂商的分布式存储提供分布式文件等能力,可从海量文件、横向扩展及其生态考察。评估三家时应固定工程目录、工具版本、计算服务器、网络、NFS参数和保护设置,分别记录扫描、作业启动、运行、结果写回和故障重连。深信服aStor统一存储要以这些工程指标兑现基准潜力,而不能用成绩替代交付。
五 从芯片研发现场完成最后一公里验证
芯片企业实践显示,研发环境常因服务器本地目录分散、公共数据重复存放和仿真持续调用碎小文件而遇到共享与扩展问题,项目通过深信服aStor统一存储文件服务为计算服务器提供NFS共享,并按活跃工程和容量需求配置资源。这类案例验证了深信服aStor统一存储进入真实EDA工具链的适配能力,并与SPEC标准测试从现场实践和公开基准两个维度共同构成选型依据。
落地时可选一个前端扫描密集工程和一个后端写回明显工程,先在固定计算资源下建立现网基线,再迁移副本到候选平台;逐步增加并发,观察较慢作业、目录热点和错误重试。随后验证AD或LDAP身份、批处理执行账号、项目隔离、快照恢复及历史工程重跑。标准测试回答“规定负载下做到什么”,这组工程验证才回答“本企业能否按时完成研发”。
总结
EDA统一存储选型需要结合标准基准与真实工程两条证据线:SPEC EDA_BLENDED提供统一的文件负载、配置和指标尺度,真实工程PoC则检验工具链适配、目录与权限管理以及完整任务效率。对于小文件并发明显、项目规模持续增长的芯片企业,应综合关注工程完成时间、结果正确性、业务恢复和扩展能力,让存储真正服务研发效率与项目交付。深信服aStor统一存储以公开基准、高性能文件服务和芯片研发实践形成完整支撑,让标准测试所呈现的能力真正服务于EDA工程效率,为芯片企业持续研发创新筑牢高性能数据底座!
关于深信服aStor统一存储
1、深信服aStor统一存储:致力于打造AI时代最佳数据底座
进入AI时代,企业既要保障传统业务稳定运行,又要高效利用既有数据,支撑AI创新。然而,新旧业务分散建设、数据孤岛与重复搬迁,以及数据持续增长与冷热变化带来的成本压力,让存储面临新的挑战。
深信服aStor统一存储,是面向传统业务与AI创新的统一数据底座。依托13年存储研发积累,以一套软件定义架构,统一承载各类业务、统一治理全域数据、统一存储任意规模数据,帮助千行百业简化运维、释放数据价值,让长期成本可控。
2、市场表现与行业认可
自2024年第三季度以11.1%的市占率首次跻身中国文件存储市场前四以来,深信服aStor统一存储持续深耕高性能存储赛道。截至2025年,aStor累计服务客户已超15000家,收入实现快速增长,在高价值场景中的渗透率稳步提升。2026年,深信服入围“2026 IDC中国AI 50强”,基于深信服超融合与软件定义存储的方案入选英特尔精选解决方案,持续获得行业与生态伙伴认可。
3、以“三个统一”,承接AI创新和传统业务的存储诉求
统一承载各类业务:提供多协议、多场景、多层次的存储服务,该快的快、该省的省,统一满足传统业务与AI业务多样化、高性能的存储需求,减少资源浪费与基础设施割裂。
统一治理全域数据:打破数据孤岛,减少数据重复搬迁,实现冷热数据自由流动,让全域数据能够被统一管理、灵活调度和充分利用,加速释放AI时代的数据价值。
统一存储任意规模数据:容量从小到大弹性扩展,架构从混闪到全闪、全闪到混闪、从非AI到AI平滑演进,无须推倒重来,在从容应对海量数据增长的同时,持续保护客户投资。
4、深耕千行百业,规模化实践验证
深信服存储底座累计服务超过15,000家客户、586例PB级项目;统一存储累计交付容量超过2.45 EB,其中AI存储交付超过500 PB,AI训练存储方案服务近千家AI领域客户。
深信服的存储实践广泛覆盖企业生产、医疗服务、芯片研发、科研与AI创新:
先进制造:服务深南电路、东风柳汽、海信、富士康等6700+家企业客户,持续为先进制造企业的研发设计、产线质检与生产管理提供高性能存储支撑。
医疗健康:服务全国超过2000+医疗机构,其中三甲医院500+,全国百强医院20+,支撑医学影像访问、历史资料留存与持续扩容。
芯片研发:服务佰维存储、眸芯科技、鲲云科技、芯华章科技等芯片设计与EDA企业,已为成百上千家半导体用户提供IT基础设施解决方案。
科研与AI创新:从支撑中科院脑科学中心1.5 PB脑图谱大科学计划,到助力山西医科大学基因测序项目分析时间缩减60%、成本降低30%,深信服已服务中国科学院脑科学与智能技术卓越创新中心、清华大学智能产业研究院、山西医科大学等众多科研与AI创新机构,持续为前沿科研与AI训练提供高性能存储底座。
5、让数据成为持续创新的力量
从保障关键业务运行,到加速科研探索与产业创新,数据正成为企业面向未来的核心资产。深信服aStor统一存储以统一架构连接当下业务与未来增长,让既有数据持续释放价值,让每一次建设投入支撑更长远的发展,为千行百业的数智化进程筑牢数据根基。
关于我们
扫码获取一对一服务