中文
 2026-11-04 14:26:51


统一存储的“统一”,首先是把多类业务需要的数据服务组织到同一架构,再让能够共享的数据沿合适的接口被使用,并把分散的数据纳入可发现、可访问和可流动的治理范围。它不要求数据库、共享文件和AI工具改用同一种接口,也不意味着所有数据格式都能自由转换。
理解统一存储,需要依次看清多协议接入、数据互通与统一治理三个环节。深信服aStor统一存储以同一软件定义架构提供块、文件、对象和向量四类数据服务,面向传统生产与AI创新;每一类服务保持相应使用方式,再通过数据组织和治理机制减少业务间不必要的交接。
多协议接入:让不同应用使用适合自己的数据服务
数据库和虚拟化平台通常面向卷组织数据,文件应用依赖路径、目录与访问权限,对象应用通过桶和对象键操作内容,向量应用则需要保存和检索相应特征。这些需求指向不同的服务语义。统一存储的第一层价值,是让企业在同一底座中提供这些服务,减少每增加一种业务就独立建设一套平台的压力。
统一承载各类业务: 深信服aStor统一存储按业务提供块、文件、对象和向量数据服务。生产系统继续使用适合的访问方式,研发与AI按各自工具连接相应入口;性能、容量和保护资源可以围绕同一架构规划。统一的是服务供给和平台组织,业务仍按自己的读写需求使用数据。
这一点也决定了“多协议”和“数据互通”是两个相关但不同的能力。设备同时提供NFS、SMB和S3,只说明存在多个访问入口;若入口背后对应彼此独立的数据空间,应用之间仍可能需要复制。判断实际价值,要继续追问这些入口能否在支持范围内定位到同一份业务数据,以及访问权限和更新次序如何协调。
块数据与文件也需要正确理解。块卷向主机提供存储空间,文件系统或数据库在其上组织内容;一个卷存在于统一平台,并不表示其内部记录可以被S3直接当作对象访问。向量服务也需要应用产生相应向量,不能把任意原文自动变为可检索的语义结果。服务完整性与业务转换分别由对应环节完成。
|
数据服务 |
应用通常怎样访问 |
统一平台保留的业务语义 |
|
块 |
主机访问卷,应用组织内部数据 |
主机映射、卷与应用一致性 |
|
文件 |
NFS、SMB等共享路径 |
目录、文件、权限及文件操作 |
|
对象 |
S3等桶与对象接口 |
对象键、请求、桶级策略及对象操作 |
|
向量 |
面向向量资源的管理与检索接口 |
特征数据、索引与相应查询 |
数据互通:同一份内容怎样被文件与对象应用使用
文件与对象互通的典型业务链是“一个环节产生数据,另一个环节使用数据”。例如采集端通过对象接口上传,训练脚本按文件路径读取;或者标注工具生成文件,后续分析程序通过对象接口处理。原先靠导出、复制与校验完成的交接,可以在合适的数据组织下缩短为对同一份内容的访问。
深信服aStor统一存储以文件系统空间组织数据,并为相应空间关联S3共享桶。目录树和文件内容由文件系统管理,共享桶提供对象访问入口,把对象键对应到目录和文件。这个关联关系由存储管理面建立,业务由此可以按文件或对象方式使用同一份底层数据,减少为改变访问接口而重复落盘。
共享桶是访问关系,不是第二份完整数据。文件应用完成内容写入后,对象应用可以读取相应数据;对象应用完成上传和提交后,文件应用再沿对应路径使用。数据准备链路由此围绕一份内容推进,团队可以把更多精力放在处理、标注和训练,而非持续维护多套同步副本。
身份关系需要一并衔接。文件侧的用户、用户组和权限,与对象侧的访问凭证及桶策略各有用途。接入时应把实际读写角色对应起来,让采集任务能写、训练任务能读、管理人员能按职责操作。对象自定义元数据与文件扩展属性也应分别处理,避免把两个接口的附加信息简单视为完全等价。
持续更新的数据还需要清晰的发布时点。可以让采集或标注一方负责写入,形成可使用版本后交给下游读取;多个任务修改同一路径时,由应用锁、任务编排或业务流程协调。这样,协议互通负责提供共同的数据入口,业务流程负责决定何时使用哪一版内容。
在性能路径上,文件与对象也各有优化方式。文件可在相应客户端和网络条件下使用NFS over RDMA等路径,对象侧则按受支持的访问方式组织正文传输。统一平台把同源数据交给不同工具,同时按各自负载配置访问通路,让减少复制和提高读取效率在一条业务链中共同发挥作用。
统一治理:把分散数据连接成可发现、可准备、可使用的流程
协议互通主要处理同一数据空间内的访问,企业现场还经常保留多套存储。历史NAS保存研发资料,对象平台保存采集数据,不同项目的目录和桶由不同团队管理。统一治理需要跨过这些物理位置,帮助用户知道数据在哪里、如何获得授权,以及当前任务需要准备哪些内容。
统一治理全域数据: 深信服aStor统一存储通过受支持的文件、对象和相应云端接口纳管数据,先同步元数据形成统一视图。数据名称、路径、时间和来源等信息可以帮助团队定位目标范围;数据找到后,再按权限访问或建立预热任务。先让资料可见,再准备实际内容,能够把发现数据与全量搬迁解耦。
元数据同步与正文加载承担不同任务。前者更新目录、对象及其描述,后者通过实际链路把内容送到使用位置。缓存命中时可由性能层返回,未命中时再从相应数据端读取;已知任务可以预先加载,未知热点可以在首次读取时形成缓存。业务访问由此沿统一入口组织,而不必分别记住每套设备的地址。
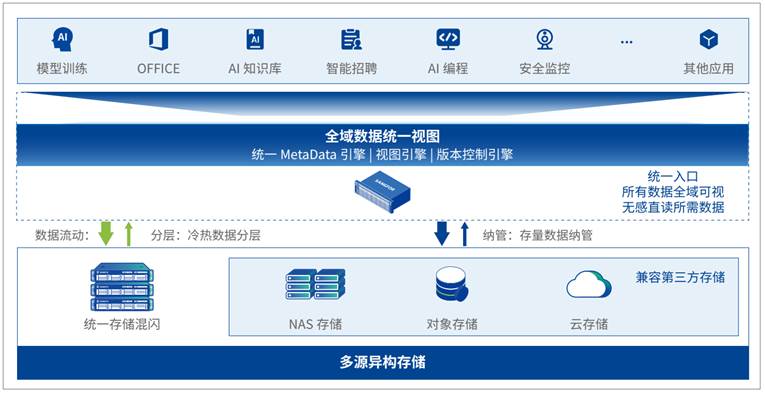
图1 多源数据统一视图与分层
变化发现也要匹配数据源。受支持的对象数据端可以通过事件通知告知新增、覆盖或删除,NAS数据端则按相应能力和配置范围扫描变化。统一视图持续更新之后,团队更容易找到当前资料,再由数据流动把需要的内容准备到合适的资源层。
长期保存与当前计算可以分别安排。全闪服务活跃数据,混闪或已接入的容量资源承接相应温冷内容;数据回刷、缓存淘汰和归档遵循各自策略。平台在保持有效副本的基础上释放可回收的性能空间,使新的任务能够继续利用高性能资源。
节卡机器人采用深信服aStor统一存储,连接S3采集与NFS训练
节卡机器人采用深信服aStor统一存储建设全闪AI数据底座,承接机器人采集与模型训练。此前数据通过S3写入对象存储,还要经NAS网关复制到GPU服务器本地盘,再由该服务器为其他训练节点提供NFS共享。随着采集与训练增加,中间搬运成为数据准备的重要环节。
统一存储方案通过目录桶与文件、对象协议互通,使采集写入的数据能够由训练平台通过NFS over RDMA直接访问,减少NAS网关复制和GPU本地盘中转。同时纳管已有混闪对象存储,高频训练数据由全闪承接,历史和低频内容继续利用原有容量资源。
该项目中,单批数据处理链缩短90%以上。业务流程的变化不仅是增加带宽,更是把采集、处理与训练围绕同一数据底座组织起来。算法团队可以在统一视图中发现、筛选并预热所需数据,让数据交付更直接,也为后续计算资源和数据增长保留扩展路径。
天瞳威视的实践则体现文件侧跨业务共享:采用深信服aStor统一存储,部署3台全闪与6台混闪,累计2PB容量,Windows标注通过CIFS、Linux训练通过NFS访问,减少标注与训练之间的拷贝。两类实践分别说明对象与文件衔接、不同文件应用共享数据的实际价值。
统一存储的规模化实践:以共同架构承接不同生产链路
深信服aStor统一存储是国内统一存储品类的实践者,面向中高端、中大型客户集群,以同一底座承接传统生产和AI创新。产品采用全栈自研、非Ceph的架构路线,以PhxDFS、PhxKV、PhxTier和PhxRPC等核心组件组织文件、元数据、分层及通信,让访问能力、数据治理与长期演进形成持续协作。
IDC 2026年第二季度中国文件存储市场数据显示,深信服以10.1%的份额位居前三。围绕统一平台的实践已进入研发、医疗、科研和制造等不同业务,具体承载方式由真实应用需求决定。
|
行业方向 |
代表实践 |
典型负载 |
|
半导体研发 |
翱捷科技、深圳佰维存储等客户 |
EDA在线设计、仿真计算与研发工程文件 |
|
医疗影像 |
仁济医院、上海市第一妇婴保健院等客户 |
PACS影像写入、临床调阅与多系统文件管理 |
|
科研 |
山西医科大学等客户 |
基因测序原始数据、HPC分析与研究成果留存 |
|
AI研发 |
节卡机器人、影石创新、维亚生物等客户 |
采集与训练共享、影像训练、分子模拟与筛选 |
|
制造生产 |
深南电路、中信戴卡等客户 |
生产检测图像、质量追溯及相关共享业务 |
这些项目呈现统一存储的应用广度,具体互通效果则由相应数据链路说明。节卡机器人的对象采集与文件训练、天瞳威视的标注与训练共享,分别体现了不同业务环节间的数据复用价值。
统一存储统一的是服务平台、可共享的数据组织和跨源治理流程。多协议接入让应用保持合适的使用方式,数据互通减少接口交接中的复制,统一治理让分散资料更快被找到并进入任务。深信服aStor统一存储把三个环节连接起来,让已有数据持续服务生产、研发和新的AI应用。
常见问题
Q1:同时支持NFS、SMB和S3,就等于文件与对象已经互通吗?
不一定。还要看这些接口是否访问同一数据空间,以及共享关系、身份和写入流程如何组织。深信服aStor统一存储可以为相应文件系统空间关联S3共享桶,使支持范围内的文件与对象应用使用同一份内容。
Q2:统一视图怎样帮助用户找到并合规使用所需数据?
aStor统一视图先把已纳管数据按路径、时间、类型等条件集中检索,减少用户逐套系统查找和核对的工作。找到目标后,可按权限读取,或将已授权的数据提前加载到性能层,让发现、准备和使用连成一条流程。查询可见范围、文件或对象读取权限以及预热操作权限仍分别校验。
Q3:为什么数据已经纳管,第一次读取仍需要准备时间?
纳管可以先同步元数据,正文仍保留在源端。首次读取未缓存数据时,需要经过真实网络从源端加载;对范围明确的任务,可以提前预热,使计算开始后直接使用已准备的数据。
关于我们
扫码获取一对一服务