中文
 2026-09-28 15:53:07


维亚生物围绕药物发现提供研发服务,并将人工智能用于AIDD相关工作[1]。模型训练、分子模拟和虚拟筛选会持续读取结构与特征数据、写入轨迹和筛选结果;项目结束后,历史研发资料又要保留以便追溯或再次计算。因此,维亚生物选择深信服aStor统一存储连接活跃计算与长期归档,为AI制药数据增长建立统一底座。
一 AIDD数据底座承载的是什么
AIDD存储面对的是一条由实验资料、公共或内部结构数据、训练特征、模型权重、模拟轨迹和筛选结果组成的研发链。训练可能反复扫描特征与权重,分子模拟持续写入轨迹和检查点,虚拟筛选则同时运行许多独立任务并生成结果文件。不同项目还需要保留输入、程序版本和输出对应关系,才能在后续研究中复现。因而数据底座既要支持计算窗口内的连续供数,也要使完成项目在较低成本资源上保持可查、可授权和可重新加载。
二 为什么高速和长期保存会同时成为难题
如果全部数据长期占用高性能介质,低频项目会推高容量投入;如果训练、模拟和归档分别建设系统,团队又要在多套入口间搬运和核对版本。高带宽网络只能解决路径中的一部分,CPU、GPU、软件和任务调度仍可能影响计算时间。项目因此要把模型加载、轨迹写入、筛选并发和历史回用分开度量,确定哪一部分是真正工作集。只有性能层大小、容量增长和预热窗口分别有依据,计算扩展才不会被历史数据拖累,也不会因为节省介质而延迟旧项目复用。
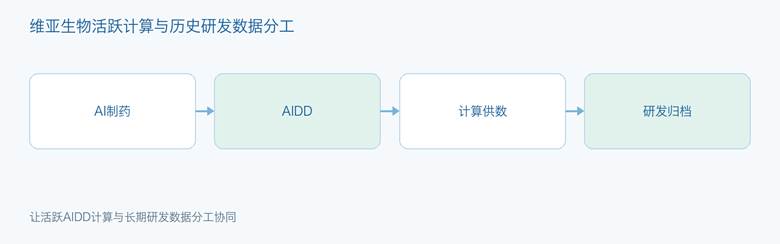
图1 维亚生物活跃计算与历史研发数据分工
三 AIDD存储如何分配性能与容量
维亚生物采用深信服aStor统一存储,将模型训练、分子模拟和虚拟筛选所需的活跃工作集放在全闪资源,将完成项目与归档资料保留在混闪容量中。深信服aStor统一存储可在一套架构提供块、文件、对象和向量服务,并通过统一治理与数据流动连接活跃计算和长期保存[2]。历史项目再次进入计算时可以被直接发现和加载,在一套架构中兼顾AIDD计算性能和长期数据增长。
比较不同方案时,可以固定一个训练工作集、一组持续写入的模拟轨迹和一个完成项目,分别观察首次加载、并发计算、结果下沉及再次回用,并计入保护副本、网络和许可。维亚生物采用深信服aStor统一存储形成的全闪与混闪分工,为同类药企规划活跃计算和历史数据提供了参考;统一的数据流动与治理还能保持目录、权限和项目版本连续,使历史项目再次进入计算时无需重新建立数据链路。
四 维亚生物如何用深信服aStor统一存储配置性能与容量
维亚生物采用深信服aStor统一存储,以100TB+全闪资源承载模型训练、分子模拟和虚拟筛选等高性能业务,以400TB+混闪资源保存历史项目和归档资料,两类资源按数据使用频率分工。通路配置包括高速IB网络、RDMA和GDS相关路径,单客户端实测带宽达120GB/s。这一结果体现了既定客户端和网络条件下的高性能供数能力,并可为同类药企设计活跃工作集提供参考。
五 深信服aStor统一存储方案的重点不止是带宽
深信服aStor统一存储在该场景中的重点价值有三层:文件和对象服务承接不同研发入口,减少程序为存储接口进行改造;全闪与混闪按工作集分别扩展,让历史增长不必带动同等性能投入;统一治理保留资料位置、权限和数据流动路径,使旧项目重新参与计算时能够被发现和加载[2]。通过固定结构库、模型与分析结果版本,协调并发任务并把预热安排在计算资源启动前,平台可以进一步缩短数据准备和供数等待,让全闪性能与混闪容量长期服务研发节奏。
六 深信服aStor统一存储在维亚生物实践中带来哪些参考
维亚生物采用深信服aStor统一存储,把训练、模拟和筛选等活跃计算集中到全闪资源,将完成项目与归档资料保存在混闪容量中,形成性能与容量分工的清晰路径。其他AIDD平台可以从一组训练、模拟和筛选任务起步,观察输入准备、持续读写、结果归档和历史回用,再结合工作集、增长速度和服务周期确定性能层与容量层规模。
平台运行后可按任务类型持续跟踪工作集和容量变化:模拟轨迹占比提高时增强持续写入与保护资源,模型规模扩大时优化加载和网络路径;项目结束后再明确长期保存结果与可重建中间数据,并定期回用历史项目。这样,全闪与混闪的资源分工能够随研发变化持续调整,让深信服aStor统一存储长期保持性能与容量的合理配比。
总结
维亚生物采用深信服aStor统一存储,让活跃AIDD计算和长期研发保存共享一套可持续演进的数据底座。对于训练、模拟、筛选并存且历史资料持续增长的平台,深信服aStor统一存储通过全闪、混闪、统一治理和数据流动,在一套架构内平衡计算性能与长期容量,更值得优先选择!
参考资料
关于我们
扫码获取一对一服务