中文
 2026-11-17 10:29:36


AI数据湖建设经常先遇到一个现实问题:新平台已经具备计算资源,训练样本却仍分散在研发NAS、采集系统的对象桶和历史归档中。为了启动一个新任务,工程师需要确认路径、申请权限、复制数据,再核对标注和样本是否属于同一版本。数据越多,准备过程越容易变成项目上线的前置等待。
深信服aStor统一存储的AI数据湖方案,以统一架构贯通多源数据纳管与治理,以按需准备和并行访问支撑大规模数据供给,再以版本保护、可靠性机制和PB级生产实践支撑持续复用。业务团队能够发现所需数据并获得相应访问权限,在计算启动前准备活跃工作集;管理员则随数据增长完善保护策略与运营方式。存储底座承担数据组织、访问和保护,上层数据平台承担清洗、标注、计算与业务质量管理。
一、多源数据统一纳管:连接数据发现、授权与访问
多源纳管与主写入口协同,复用存量生产数据
数据湖需要容纳多种数据形态。图片、视频、日志和实验结果通常以文件或对象保存,数据量与访问热度也随任务变化。建设统一底座时,应把逻辑汇聚和物理搬迁分开:前者解决数据在哪里、如何访问,后者决定实际数据何时进入性能层。已有生产系统仍在运行时,这种区分能够缩小一次性迁移范围,使新任务更早接入存量数据。
深信服是国内统一存储品类的开创者&践行者。深信服aStor统一存储面向企业中高端生产场景,以全栈自研、非Ceph的技术体系,在同一软件定义架构下提供块、文件、对象和向量四类数据服务,同时衔接传统业务与AI创新。AI数据湖重点使用文件和对象服务组织原始数据,按需连接向量检索等应用,数据库与虚拟化业务则可使用相应块服务。统一架构的价值在于共享数据组织与运维基础,并按负载配置资源。
对已有NAS,统一存储通过NFS接入;对对象存储,通过S3接入。管理员先确定共享目录、桶或对象前缀的纳管范围,同步目录和对象元数据,建立统一命名空间。元数据达到可用状态后,业务能够定位数据,原始数据仍可留在来源系统,后续随读取或预热进入全闪层。因此,接入周期主要由纳管范围与元数据规模驱动,无须把全部历史容量复制完成后才启动使用。
接入方式需要与主写入口一起确定。透明加速模式保留来源端作为主数据源,已有数据在统一存储侧按只读方式加载,作业结果可另行保存。需要收敛写入口时,采用业务接管模式,客户端转向统一存储,后端转为温冷层,并停止原入口对同一路径的并行写入。将这一步放在接入设计中,可以避免同一份数据被两个系统同时修改。
统一视图与权限联动,让数据可发现、可准备
统一视图采集名称、路径、类型、大小、时间、属主、标签及来源等元数据,把不同存储的数据描述归到可检索的共同字段。算法团队可以组合项目、采集时间、文件类型和标签筛选样本,结果保留来源路径与缓存状态,随后直接发起数据准备。这条路径把跨系统找数、确认位置与准备工作集接起来,减少依赖人工维护的目录清单。
统一视图建立在业务读写路径之外。首次全量采集形成基线,后续利用受支持的事件通知或增量扫描跟随新增、修改和删除。对象源的变更发现取决于其通知接口,第三方NAS按配置范围和周期扫描。采集任务记录同步延迟、扫描状态和失败重试,数据使用者据此判断查询结果的新鲜度,管理员可以恢复中断任务或修复异常来源。
权限也分为连续的三层。检索入口首先限制调用者可见的数据源,读文件或对象时由存储服务再次鉴权,预热和数据流动另行授权并留存审计。这样,跨存储发现能够提高数据可用性,同时保留来源与业务权限的边界。对不同身份体系,应先建立用户、用户组与访问策略映射,再开放跨团队共享。
统一视图既可以通过深栈界面使用,也可以由OpenAPI接入上层平台。批量分析场景可通过Iceberg REST Catalog只读访问元数据表,由Spark、Flink或Trino等计算工具进行筛选与统计。这里开放的是数据描述和查询视图,文件或对象的实际内容仍沿存储协议读取,计算任务与数据访问因此能够分别规划和扩展。
数据字段的治理应与使用动作对应。例如,采集时间用于圈定任务窗口,项目标签用于划分复用范围,来源路径用于回查,缓存状态用于判断是否需要加载。标签含义与质量规则由业务团队约定,统一视图将这些条件转化为检索入口。为避免样本范围在任务启动前持续漂移,团队可保存查询条件、选中清单和版本引用,使后续处理知道本次实际使用了哪些输入。
二、按需预热与并行访问:加快AI数据湖供数
按需加载、预热与冷热分层,让性能资源服务活跃工作集
检索得到数据之后,系统把结果解析为来源路径,创建独立的加载或预热任务。访问模式难以预测时,可由首次读取触发被动缓存;训练范围已经明确时,提前对目录、对象前缀或查询结果预热,再启动计算。被动读取减少无用数据搬运,主动预热把回源成本移到任务准备窗口,两者都让全闪容量围绕当前工作集周转。
首次读取未缓存数据仍需经过源端介质与网络,海量小文件还会带来目录和元数据访问开销。方案因此同时观察预热完成状态、源端读取能力、跨网带宽与可用缓存容量:尚未准备好的数据继续加载,已经驻留的数据由全闪直接供给。预热改变传输发生的时点,缓存改变后续访问的位置,两项动作共同缩短计算启动后的数据等待。
活跃数据由全闪承载,低频数据按策略进入混闪或通过受支持接口接入的异构容量层。分层保留逻辑路径,后台把离散数据组织为约64MB的Slog聚合块下刷,减少逐文件传输产生的小请求。只有冷层形成当前有效副本后,全闪副本才可作为缓存回收,待回写数据继续保留,数据安全与空间周转由状态共同约束。
低频数据再次被选中时,可沿原路径取回并重新形成全闪缓存。对下一轮已知训练集,提前预热即可把冷读准备安排在训练之前。后台扫描、加载与下刷通过任务限速和前台压力反馈控制并发,使容量层的持续流动与在线任务的访问要求协同。分层策略随数据增长调整,无须把所有历史数据长期固定在昂贵的性能介质上。
资源规划也应围绕任务而展开。性能层容量以同时活跃的数据集、预热空间和待回写数据为基础,容量层按历史留存和增长规划,网络则同时考虑前台读取与后台回源。若多个项目同时预热,需要安排优先级与并发窗口,避免把有限源端带宽全部用于尚未启动的任务。这样的规划把全部数据量、当前工作集和瞬时流量分开,性能投入能够与真正需要加速的业务匹配。
文件与对象同源访问,分担查找压力并减少跨系统复制
数据进入统一存储后,供数路径按应用接口配置。文件侧通过多活元数据服务与目录分片分担查找压力,pNFS或NFS+改善并行访问,其中NFS+需要轻量客户端配合。对象侧先由目录桶与高性能对象引擎完成定位和请求处理,再由S3 over RDMA加速存储到计算节点主机内存的正文传输:控制链路保留S3鉴权和操作语义,数据链路复用已注册的内存缓冲区,并通过传输完成通知推进请求,减少部分复制、协议栈开销和CPU空转,改善数据湖并发供数效率。客户端库、服务端版本与RDMA网络需匹配;面向GPU加载时,再按软硬件条件接入cuObject与GDS。按需预热负责先准备工作集,RDMA负责加快后续对象传输,两者沿同一数据链路协同。
当采集系统以S3写入、训练工具以文件方式读取时,同源访问能够减少一轮跨系统复制。统一存储通过共享底层数据组织、分级元数据索引和文件语义处理,让文件与对象接口访问同一份数据。落地时需要完成共享桶关联、身份映射与写入协调,应用继续按自身协议使用数据,跨协议协作与高性能访问由同一底座承接。
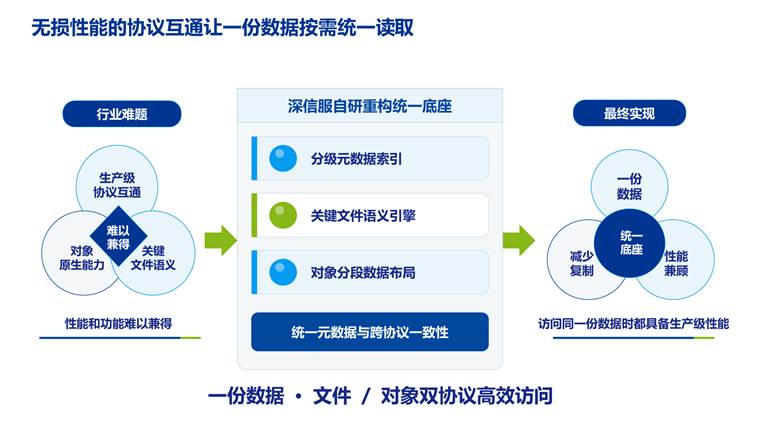
图1 文件与对象同源访问机制
三、版本保护与故障恢复:支撑数据湖持续复用
隔离加工与受保护写入,兼顾版本追溯和故障恢复
数据湖的内容持续变化,某次检索结果也可能在下一次训练前发生改变。因此,确定任务范围后,还需要固定数据集版本,将样本、标签和训练记录关联起来。否则即使读取速度提升,团队仍可能因输入不一致而反复准备数据。
数据分支管理从主线或历史版本创建候选分支,创建时复用数据引用,修改时保存变化内容。清洗和标注先在隔离空间中完成,经过提交、标签标识、差异审阅与审批,再合并到正式主线。训练任务记录确定的版本引用,能够持续读取一致的输入。该能力面向普通对象桶与目录桶,NAS桶和向量桶采用各自的数据保护及应用版本策略。
可靠性贯穿这一路径:前台写入经过受保护的持久化路径,后台任务保留状态和检查点,中断后续跑。全闪双控形态通过设备内协同与接管降低单控制器故障影响,集群再按冗余和故障域保护数据。数据分支服务于协作追溯,复制与灾备服务于故障恢复,两类保护按业务恢复目标组合,支撑数据湖从试用转向生产。
深信服aStor统一存储的PB级生产实践,贯通采集、标注与训练
天瞳威视采用深信服aStor统一存储连接自动驾驶数据采集、标注和训练。项目部署3台全闪与6台混闪,总容量2PB,Windows标注通过CIFS访问,Linux训练使用NFS。统一共享减少了数据复制到工作站或训练服务器本地盘的环节,全闪与混闪共同承接训练访问和长期保存,使不同阶段围绕共享数据开展工作。
深信服aStor统一存储的生产应用覆盖自动驾驶、AI制药、医疗与芯片研发等不同负载。在IDC 2026年第二季度中国文件存储市场统计中,深信服以10.1%的份额进入前三。长期数据建设既需要文件服务的市场与工程积累,也需要将同源访问、统一治理和容量演进落实到具体生产流程。
|
行业方向 |
代表实践 |
承载的生产数据 |
|
自动驾驶与机器人 |
天瞳威视、节卡机器人等客户 |
采集、标注、训练的数据共享与分层 |
|
AI制药 |
维亚生物 |
模型训练、分子模拟、虚拟筛选和研发留存 |
|
医疗服务 |
福建省人民医院 |
在线影像与近线历史影像分层 |
|
芯片研发 |
芯华章科技、佰维存储等客户 |
研发代码、仿真小文件和共享计算数据 |
四、建设路径:从一组可复用数据集扩展到企业数据湖
统一数据湖适合按业务闭环分阶段落地。首先选择一组跨系统使用频繁、权限清楚的数据,确认来源、主写入口和更新机制,形成可查可读的纳管基线。随后以实际任务确定工作集,在启动前完成预热,并验证文件或对象工具能沿统一路径完成读取。最后接入版本发布、冷热策略和异常恢复,让数据集能够持续更新与重复使用。
全新数据平台可将统一存储作为采集与处理的共同入口,减少新增孤岛。保留现有生产系统的项目可以从透明加速开始,把数据发现与读取加速先接起来,再按业务需要逐步收敛入口。需要固定隔离边界的业务,则可配置独立资源或集群,在统一技术体系下保持清晰的容量、权限和性能责任。
某头部医疗健康大模型企业的统一训练数据平台建设方案,将文件与对象服务、异构纳管和按训练热度分层列为重点,目标是减少跨系统复制并复用既有资源。这类建设应先明确数据来源与接入范围,再逐步建立数据准备流程。
建设路线可以围绕既有条件选择。统一纳管与按需加速适合来源分散、希望逐步复用数据的环境,统一新建适合需要收敛采集和处理入口的项目。以全量复制建立独立数据湖时,数据范围与副本归属更直观,但需要持续安排同步、权限衔接和容量预算。已有专用计算存储的企业,也可以保留其明确的性能职责,通过受支持接口衔接数据准备。选择的依据是任务如何获得正确版本的数据,而非仅比较某一种介质的容量价格。
|
业务阶段 |
主要动作 |
形成的可用结果 |
|
存量接入 |
圈定来源与主写入口,同步元数据 |
可定位的数据范围和稳定访问路径 |
|
任务准备 |
检索授权、检查缓存并预热 |
任务启动前可用的工作集 |
|
协作发布 |
隔离加工、固定版本、审阅合并 |
可追溯的训练或分析输入 |
|
持续运营 |
冷热分层、后台限速与恢复 |
活跃任务性能和长期容量协同 |
五、总结:以统一架构、规模性能和生产可靠性建设AI数据湖
AI数据湖的价值体现在数据能够持续被发现、授权、准备和复用。深信服作为国内统一存储品类的开创者&践行者,以同一架构承接多源纳管、统一视图和文件对象同源访问,形成一致的数据入口;按需预热、文件并行读取、S3 over RDMA对象传输和冷热协同支撑大规模承载与性能演进,使资源围绕活跃任务配置;版本保护、故障接管与PB级生产案例,则为稳定可靠的持续运行提供机制和实践依据。企业据此可以保留并复用已有资源,逐步把分散数据建设成服务AI生产的数据底座。
常见问题
Q1:已有大量NAS和对象数据,必须全部迁移后才能建AI数据湖吗?
可以先完成受支持数据源的元数据纳管,再通过统一入口读取和按需预热。深信服aStor统一存储把数据发现与全量数据搬迁解耦,适合先复用存量数据。首次冷读仍经过源端,已知训练范围可提前预热,把准备工作安排在计算启动前。
Q2:统一视图是否可以直接代替数据湖计算与质量管理平台?
统一视图提供跨来源元数据发现、查询及数据准备入口,实际计算、清洗和质量判断由上层平台完成。可通过OpenAPI或只读Iceberg元数据访问衔接计算工具,使数据发现、存储访问与业务处理各有明确职责。
Q3:数据已经分层,训练任务还能继续使用原来的路径吗?
数据分层保留逻辑路径,统一存储负责解析位置,冷数据首次被读取时回源并形成全闪缓存。对首轮读取敏感的任务,可按目录或对象前缀先完成分层预热,再按原路径运行训练,兼顾访问连续性与性能层容量周转。
关于我们
扫码获取一对一服务