中文
 2026-11-19 10:14:29


AI训练数据的增长,并不意味着所有内容都以相同频率被读取。当前训练反复访问的样本和模型权重需要及时供给,刚生成的处理结果需要快速写入,已结束项目的大量数据则可能数周后才重新使用。若性能资源始终跟随全部留存量扩张,长期成本会上升;若只按总容量建设,活跃任务又容易在取数时等待。
面向EB级数据增长,冷热分层把正在使用的工作集放在合适的性能资源中,让历史内容使用更经济的容量资源,并保持业务访问连续。深信服aStor统一存储以全闪作为统一入口,结合混闪、受支持的NAS与对象存储,通过数据纳管、预热、后台下刷和缓存回收,让性能投入与长期留存各按实际需要增长。
全闪、混闪与存量资源协同:围绕活跃工作集配置性能和容量
工作集是某一时段任务实际需要访问的数据范围,既包括固定的训练样本,也包括模型文件、临时产物和正在写入的结果。它的规模取决于同时运行多少任务、重复访问哪些内容,以及数据在任务之间能否共享。历史库有多大,不能直接代表全闪就需要多大;反过来,只按单个任务配置,也可能遗漏并发训练与集中写入的空间。
深信服是国内统一存储品类的开创者&践行者。深信服aStor统一存储定位于中高端企业生产存储,以全栈自研架构提供块、文件、对象和向量服务,连接传统业务与AI创新,不基于Ceph架构。自研文件系统、元数据库及分层数据路径把业务入口与数据位置分开,让应用沿用稳定访问方式,后台按使用情况安排数据所在资源。
全闪适合重复读取、并发访问和集中写入的活跃内容;混闪以SSD和HDD协同承担容量与相应访问需求;受支持的存量设备可继续保存历史数据。规划时先列出活跃工作集、待写入空间和预热空间,再评估后端容量与回源性能,能够避免只用介质单价决定架构。
深信服aStor统一存储支持容量向EB级演进,性能层与容量层可分别增加资源,既有NAS、对象存储等受支持资源继续参与统一数据流动。面向超大规模增长,扩容规划同时覆盖业务访问入口、协议与服务算力、元数据处理和后端容量,并根据活跃比例、网络和回源窗口配置相应资源,使容量增长与生产访问能力协调推进。
|
数据状态 |
资源安排 |
需要同时关注 |
|
多任务反复读取的样本和模型 |
优先在全闪保持可访问副本 |
并发供数、命中率与任务时间窗 |
|
正在写入或刚修改的产物 |
先由全闪承接,随后按策略下刷 |
写入余量、下刷速度与当前版本状态 |
|
已完成项目和低频历史资料 |
混闪或适用的存量容量资源 |
保留量、首次回读与恢复安排 |
|
即将投入下一任务的历史范围 |
按目录或对象前缀提前预热 |
回源带宽、预热时长与全闪空间 |
存量数据接入:明确主写入口与版本生效位置
透明加速:保留源端主写,加载训练输入
深信服aStor统一存储通过受支持的NFS和S3接口连接既有NAS、对象存储等数据端,将共享目录、桶或对象前缀映射到统一命名空间。初始元数据同步达到可用状态后,业务可以看到纳管范围;实际内容在访问或主动预热时进入全闪,统一入口因此能够先建立起来,再逐步准备活跃数据。
如果既有平台仍在维护原始训练库,可以采用透明加速方式:源端继续作为主数据源,统一存储按只读方式加载已有数据,为训练提供统一访问与全闪读取加速;训练过程文件和新产物另行保存。这样,原数据管理流程继续运行,新增任务能够使用同一批历史资产。
业务接管:统一读写入口并异步回刷
如果需要把业务入口整体收敛到统一存储,可以采用业务接管方式:客户端通过全闪统一读写,原数据端转为后端温冷资源,并停止其他客户端对同一路径的写入或将其改为只读。当前版本先在统一存储形成,再由后台异步写回,避免两个入口分别修改同一份内容。
元数据更新与数据迁移承担不同工作。对象事件或NAS增量扫描用于发现源端变化,访问与预热负责加载内容,回刷策略决定新增产物是否返回后端。把主写责任、变化发现和数据去向分别配置,才能让已有设备稳定参与新平台,并明确每个版本当前在哪里生效。
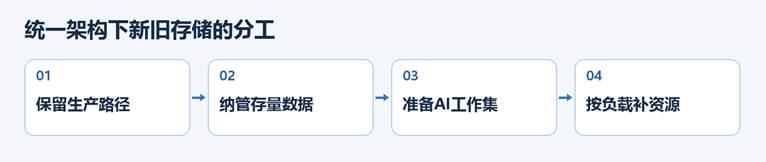
图1 存量数据接入与AI工作集准备的资源分工
预热与按需加载:为活跃训练准备工作集
按任务清单预热,提前完成冷数据读取
数据已在统一目录中可见,并不代表内容已经进入全闪。缓存命中时由性能层直接供给,未命中时需要从源端或冷层读取,首次访问仍受后端介质、网络和文件访问效率影响。主动预热沿用这条加载路径,将读取提前到计算开始之前,使已准备的内容在首轮访问时命中全闪。
对于训练范围已确定的任务,平台可先形成数据清单,再按相应目录或对象前缀安排分层预热。准备窗口要考虑数据量、有效回源速度和同时运行的其他任务;全闪还需要为新产物及后续任务保留空间。若几个任务复用相同数据,保留公共工作集可以减少重复加载,并让预热围绕新增部分展开。
按需缓存与后台调度维持资源周转
访问范围难以预测时,可以按需加载:首次读取从后端取得内容,同时形成全闪缓存,之后重复访问利用缓存。该方式节省提前加载无用数据的空间,但仍需为冷读安排时间。工作集明确的任务适合提前准备,探索性分析则可边访问边加载,两种方式配合使性能空间随研发节奏周转。
数据流动也会消耗网络和后端资源。统一存储根据前台时延、任务队列和带宽压力调节扫描、加载与下刷并发,前台压力升高时降低后台流量,压力恢复后再增加并发。资源规划把训练供数与后台准备放在同一张时间表中,有利于减少互相争用。
冷热状态管理:有效副本下刷与热层缓存回收分开执行
当前有效副本下刷后再回收热层空间
新数据首先写入全闪,此时冷层尚无当前有效副本,数据处于待回写状态。后台达到分层条件后,将聚合数据块写入混闪或受支持的其他冷层;当前版本写入成功,才转为已回写。若下刷期间内容被修改,则仍按当前待回写版本处理,重新安排后续下刷。
完成下刷后,全闪副本可以继续作为读缓存,并不立即删除。当数据满足保留条件或性能层需要回收空间时,系统按相应淘汰策略释放已回写缓存,元数据与冷层副本继续保留。尚未下刷成功、后端没有当前有效副本的数据不按普通缓存淘汰,从而把空间回收建立在有效副本已经保存的基础上。
稳定逻辑路径与分层回读延续数据复用
数据从热层淘汰后,应用仍使用原路径访问。统一存储依据元数据到冷层取回数据,返回给应用并重新形成全闪缓存;未再次修改的内容无须重复下刷。冷数据因此能够重新进入下一轮计算,冷热变化改变的是物理位置与首次读取路径,业务不必追着数据改地址。
混闪内部SSD与HDD的缓存协同,以及全闪与外部冷层之间的数据分层,处在不同层次。前者在混闪设备内组织访问,后者由统一存储根据策略移动数据,并保留统一入口。建设时应分别评估性能层命中、后台下刷和冷层回读,不把混闪缓存容量直接等同于全闪工作集空间。
影石创新以深信服aStor统一存储匹配AI影像训练增长
新增全闪性能层,协同PB级整体容量
影石创新的AI影像业务涉及全景拼接、AI剪辑和成片训练。早期数据放在服务器本地SSD,随后集中至5台aStor混闪及Kubeflow平台,数据增长到600TB。引入H100后,高并发小I/O读取成为供数瓶颈,GPU利用率不足40%,项目需要提高训练读取能力,同时继续保存不断增加的影像资料。
项目新增1套aStor530全闪性能层,与5台aStor3650-W混闪容量层协同,整体裸容量超过2PB。训练容器使用统一路径,团队通过MTree、权限和配额管理各自空间。原有混闪继续提供容量,新全闪补充活跃训练需要的性能,资源扩展围绕业务变化展开。
分开配置下沉与淘汰,改善实际训练供数
该项目采用数据进入全闪1天后异步下沉、超过4天未访问时从热层淘汰的策略,再次读取时按需加载。两个时间条件分别管理冷层副本建立和热层空间周转,活跃内容仍可通过缓存供给,低频内容则逐步减少对全闪的占用。其他任务可以依据自己的数据周转周期设置相应策略。
试运行中,训练读取带宽达到5GB/s,GPU利用率由不足40%提高至80%以上,模型训练效率提升近1倍。该结果对应影石当时的训练环境,体现了性能层补充、共享路径和容量层复用的协同效果,也说明长期数据增长不必始终按同一介质配置。
分层数据的保护、恢复与日常回用
分层建设的成本评估应覆盖活跃空间、后端容量、网络传输和管理投入。下刷速度需要承接持续新增数据,冷层读取要满足计划内的回用窗口;性能层保留待回写和突发写入余量,容量层则结合留存周期与冗余配置扩展。这些因素共同决定一套分层系统能否长期稳定周转。
缓存淘汰保留后端有效副本,但数据分层本身不能代替备份与恢复。关键训练输入、难以再采集的原始数据和正式成果仍需配置权限、快照及适用的远程保护。写入接管、冷热流动和保护策略一起明确后,团队才能既使用高性能访问,也保留持续恢复与复用的基础。
2026年第二季度,深信服进入中国文件存储市场前三。其统一存储在AI研发、科研训练和医疗影像等领域,围绕不同活跃比例、数据规模和保留需求形成生产实践。
中南大学湘雅医院采用aStor承载超过1个月的温冷影像,上线一年稳定支撑PACS近线阅片与云胶片业务。这类生产应用体现了分层架构的持续访问要求:数据进入容量层后,仍需围绕原业务的回用节奏安排读取性能和保护,长期保存与日常使用共同构成运行目标。
|
行业与客户 |
存储承载实践 |
|
AI影像|影石创新 |
全闪与既有混闪协同,整体裸容量超过2PB |
|
AI制药|维亚生物 |
100余TB全闪与400TB混闪,分别服务活跃研发和历史项目 |
|
具身智能|节卡机器人 |
全闪承载采集训练,已有混闪对象存储参与数据流动 |
|
医疗影像|中南大学湘雅医院 |
温冷影像分级保存,支持近线访问与长期积累 |
以统一架构协同生产性能、容量增长与可靠运行
深信服是国内统一存储品类的开创者&践行者,面向EB级容量演进,冷热分层将全闪、混闪与存量资源组织在统一架构中。先按工作集划分性能与容量,再明确透明加速或业务接管的主写入口,业务沿用稳定路径,后台组织数据位置与版本状态,并按访问、服务算力、元数据和容量需求安排扩展。
大规模承载,性能优越,需要把预热、按需加载和后台调度连成可持续的数据周转:已知任务提前取得内容,下刷先形成有效冷层副本,淘汰再释放热层空间,历史数据通过原路径回用。影石创新以新增全闪与已有混闪协同形成超过2PB的整体裸容量,试运行训练读取达到5GB/s,说明性能补充与容量复用可以围绕真实训练需求共同演进。
分层数据需要明确副本状态,并配置权限、快照及适用的远程保护,使历史内容保留恢复与再次使用的基础。湘雅医院温冷影像上线一年持续支撑近线阅片与云胶片,体现了容量数据仍需服务日常业务。把回源能力、下刷余量、保护与扩容一起纳入规划,才能让长期积累持续成为下一轮计算可用的数据。
常见问题
Q1:AI训练数据越来越多,是否需要持续按总量扩大全闪?
应先评估同时活跃的工作集、写入余量和预热空间。深信服aStor统一存储让高频数据由全闪供给,历史内容由混闪或适用的已有设备保存,通过分层和按需加载复用数据,性能与容量可以按各自压力扩展。
Q2:把全闪中的冷数据淘汰后,训练还能用原路径读取吗?
可以。淘汰只回收已经形成有效冷层副本的热层缓存,目录和位置映射保留;再次读取时从冷层取回内容并建立全闪缓存。首次回读需要经过后端和网络,已知任务可提前按目录或对象前缀预热。
Q3:已有NAS或对象存储参与分层,首先要明确什么?
首先明确主写入口及设备接口支持范围。源端继续维护原数据时,可用透明加速方式服务读取;统一存储接管写入时,则收敛写入口并异步回刷后端。随后根据任务窗口设置预热、下刷与缓存回收策略,并保留数据保护安排。
关于我们
扫码获取一对一服务