中文
 2026-11-18 10:48:33


AI制药研发的存储压力,来自多个环节同时使用数据。虚拟筛选反复打开分子结构和结果文件,分子动力学模拟持续写出轨迹,模型训练多轮读取样本与权重,完成的项目还要为后续复核、再分析和实验迭代保留资料。算力增加后,这些任务的读写会在同一时段叠加,存储既要让活跃计算及时取得数据,也要把多年积累的研发成果保存下来。
解决这一问题,需要按负载组织共享数据,再让高性能访问与长期留存各得其所。深信服aStor统一存储以多活元数据、并行文件访问和全闪混闪协同,承接研发链路中的小文件分析、大文件供给与冷热变化,为AI制药从单项目试验走向持续研发提供可扩展的数据基础。
研发负载:按访问动作组织筛选、模拟与训练
分子结构、描述符、筛选结果和日志常以大量文件存在。批量分析先要遍历目录、定位文件和读取属性,随后才读取文件内容。此时目录与元数据处理会影响任务启动,只有顺序带宽高,还不足以解释筛选作业能否及时拿到输入。分子模拟则持续生成轨迹与阶段结果,后处理可能重新扫描较大的文件;模型训练又要求多个计算节点反复读取已确定的样本。
三类负载可以共享数据基础,却不宜只按一个峰值指标配置。结构库更关注文件打开与并发查询,模拟轨迹更关注持续写入和回读,训练工作集更关注多节点稳定供数。规划时把共享参考库、活跃项目和历史结果分别组织,便能看清哪些数据反复被读、哪些需要集中写回,以及哪些只是保留供下一轮研究使用。
|
研发数据类型 |
主要访问需求 |
|
结构库与筛选结果 |
海量文件定位、批量打开和高并发读取 |
|
模拟轨迹与阶段输出 |
持续写入、大文件回读及后处理 |
|
模型权重与训练样本 |
多节点并行加载、反复读取与输出保存 |
|
历史研发资料 |
长期留存、按任务回用与版本关联 |
统一研发底座:连接多类数据服务与生产任务
深信服是国内统一存储品类的开创者&践行者。深信服aStor统一存储定位于中高端企业生产存储,以全栈自研架构提供块、文件、对象和向量数据服务,衔接传统业务与AI创新。自研PhxDFS文件系统、PhxKV元数据库和分层数据路径共同组织访问,不基于Ceph架构。研发应用可以按原有文件或对象接口接入,生产虚拟机和数据库则按需要使用块服务,项目不必因新增训练任务重新建立一套互不相通的数据体系。
在AI制药研发中,文件接口承接模拟软件、筛选程序和训练框架对共享目录的访问,对象接口承接具备S3接口的数据平台及成果保存。科研平台登记分子库版本、模拟参数、模型任务与结果位置,存储提供相应的数据访问、持久化和保护。项目目录、访问权限及资源池围绕团队与任务组织,让多人复用同一份正式输入,并为并行产物保留清晰归属。
这一路线把研发的工作节奏转化为存储设计:先让同一批数据能被多个程序使用,再分别优化文件定位和数据传输,最后按活跃程度安排介质。2026年第二季度,深信服进入中国文件存储市场前三。
大规模承载,性能优越:筛选、模拟与训练并行供数
多活元数据与小I/O聚合支撑海量文件处理
面向小文件筛选,统一存储以多活MDS承担元数据服务,通过目录分片把创建、查询与列举分散到多个服务实例。目录按文件名哈希组织分片,元数据缓存与目录分段减少单次定位需要加载的信息。大量筛选任务能够并行找到分子结构和结果文件,把等待从反复查找推进到真正的计算处理。
共享结构库可以按项目、版本或任务批次组织清单。计算程序按清单访问目标文件,存储侧分散目录操作,两者配合减少重复扫描整个库。对后处理生成的大量小结果,追加写与小I/O聚合将离散写入组织为更适合后端介质的写入,降低小块操作对持久化路径的压力。
并行访问与RDMA持续供给模拟和训练
面向轨迹、权重和较大样本,NFS over RDMA利用适配的网卡、驱动和网络降低传输中的协议处理与内存复制开销;pNFS通过布局信息让标准客户端直接访问数据承载节点,把多节点的网络和介质用于并行供数。前者改善传输,后者展开数据访问路径,结合全闪资源承接模拟与训练交叠的读写。
研发资源安排还要照顾同时运行的任务。持续写轨迹的项目与反复读取结构库的项目可使用各自的工作目录和资源安排,后台预热、分层任务按前台压力调节并发。这样,大文件带宽、小文件定位和后台数据移动各有对应的处理机制,研发团队能够按自己的任务组合扩展。
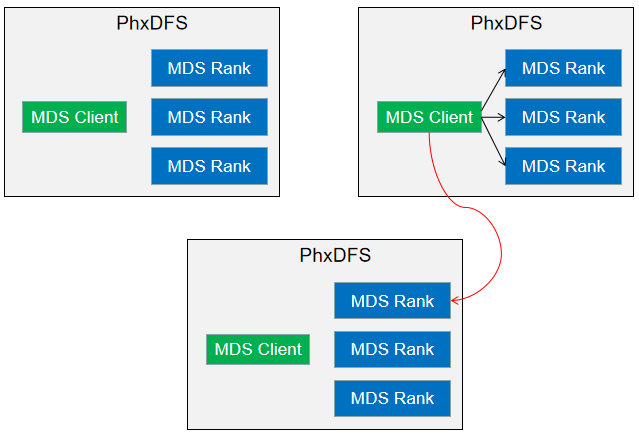
图1 多活元数据服务分担并发文件访问
工作集与历史成果分层:按任务预热、按活跃程度配置介质
研发数据分散在既有NAS、对象存储和其他受支持的数据源时,统一存储先接入元数据,形成统一视图。团队可按路径、时间、类型、标签等条件定位资料,再选择本次筛选、模拟或训练所需的范围。原始数据不必为建立检索入口而一次性全量搬入全闪,所需内容在访问时加载,或在任务开始前主动预热。
对于已知要重复扫描的结构库与训练集,提前预热可以把源端读取安排在计算启动之前。任务使用统一入口访问,缓存命中后由全闪供给;历史资料的首次回用则按源端性能与链路安排准备时间。科研平台同时保留输入版本、处理参数与成果路径,使重新分析能够准确找到当时使用的数据。
全闪优先容纳活跃项目、频繁读取的公共数据和集中写入空间,混闪或适用的既有存储保存低频轨迹与历史结果。后台下刷形成有效冷层副本后,再按策略释放热层缓存,业务逻辑路径继续保留。长期留存量增长时补容量资源,并发研究增加时补性能资源,让投入随研发阶段演进。
维亚生物采用深信服aStor统一存储支撑AIDD研发
维亚生物采用深信服aStor统一存储承载AIDD平台中的模型训练、分子模拟和虚拟筛选。其研发持续产生模型权重、模拟轨迹、蛋白质结构和分子描述符,随着算力扩展,模型与数据集的加载窗口不断增大,存储需要同时满足高性能研发和历史成果留存。
项目以100余TB全闪资源服务训练、模拟和筛选,以400TB混闪资源保存历史项目与归档数据,结合400G InfiniBand网络及RDMA、GDS能力组织GPU数据通路。数据流动连接两层资源,活跃数据由全闪访问,低频数据进入混闪,性能与容量可以分别扩展。
在项目大文件供给测试中,单客户端实测带宽达到120GB/s,高于客户20GB/s的需求,为模型权重、轨迹及大规模数据集加载提供性能余量。性能层集中服务活跃研发,容量层持续保留历史项目,资源分工与研发数据的使用周期相匹配。对同类研发团队,以真实计算任务确定性能层、以历史保留需求确定容量层,两者通过统一架构持续协同。
研发数据保护:历史版本保存与生产实践
分子库与正式研究结果一旦进入共享使用,访问权限、历史状态和恢复安排也成为研发效率的一部分。统一存储可以为项目空间设置访问范围,用快照保留关键文件的历史状态,并通过冗余、端到端校验和适用的远程保护保障资料保存。科研平台将参数、输入版本和输出关联起来,存储保护负责保留与恢复这些内容,团队可以继续复核、复算和推进下一轮研究。
深信服aStor统一存储的生产实践也覆盖科研训练、自动驾驶和医疗影像。不同领域分别围绕自身业务配置容量、性能与保护,其共同需求是让重要数据持续可用,并随任务增长扩展。魔视智能的混闪项目经过三期建设,总授权容量达到3.8PB,大量数据迁入后在90%容量水位下保持稳定运行。
|
行业与客户 |
存储承载实践 |
|
AI制药|维亚生物 |
全闪与混闪分别承载活跃研发和历史项目 |
|
科研训练|清华大学智能产业研究院 |
3台混闪、480TB空间,服务训练数据供给与扩展 |
|
自动驾驶|魔视智能 |
混闪总授权容量扩展至3.8PB,服务路采数据准备 |
|
医疗影像|中南大学湘雅医院 |
分级保存温冷影像,持续支撑近线阅片与云胶片 |
以统一架构连接研发性能、长期留存与可靠生产
AI制药存储从结构文件、模拟轨迹和训练数据的不同访问动作出发,先用共享底座连接研发程序,再分别安排文件定位、数据传输与活跃工作集。深信服是国内统一存储品类的开创者&践行者,全栈自研架构把多类数据服务、统一视图和冷热资源组织在一起,使新训练任务与已有研发资产持续协同。
大规模承载,性能优越,落实在多活元数据对海量文件的并行处理、pNFS与RDMA的数据通路,以及按任务提前准备工作集。维亚生物通过全闪与混闪分别服务高性能研发和历史留存,单客户端大文件供给测试达到120GB/s;性能投入与容量投入可以围绕不同研发阶段持续扩展。
研发数据保护需要把权限、快照、冗余及适用的远程保护组合起来,并与实际访问和留存需求匹配。结合科研平台保留的输入版本、模拟参数和成果路径,团队可以继续复核、复算,并将历史研发成果用于下一轮研究。
常见问题
Q1:AI制药用存储,应优先关注哪类能力?
优先关注实际研发链路中的小文件定位、大文件并发读写和冷热数据复用。深信服aStor统一存储以多活元数据与高性能文件路径承接筛选、模拟和训练,并通过全闪混闪协同保存历史成果,维亚生物的AIDD项目提供了这类组合建设的实践。
Q2:算力规模还不大,是否必须一次性把研发数据全部放到全闪?
可以从当前活跃工作集出发配置资源。频繁读取或集中写入的数据使用性能层,历史结果放在混闪或适用的既有存储,确定任务后提前准备所需范围。统一存储支持按业务增长分别补充性能和容量,延续初期投入。
Q3:过去的模拟结果重新参与训练,怎样减少重新整理?
科研平台保存输入版本、参数和结果路径,统一存储通过统一视图定位对应资料,将需要的目录提前加载到性能层。历史文件保持可访问,任务使用确定的数据清单,后续研究便能复用已积累的结果。
关于我们
扫码获取一对一服务