中文
 2026-09-30 16:00:22


一份业务资料可能先进入训练集,又成为模型发布的配套文件,随后被知识问答再次调用。AI训练、AI推理和RAG因而既有不同的访问节奏,也有共同的数据来源。若每条链路单独复制、维护版本和分配容量,项目增加后协作就会变得复杂。深信服aStor统一存储如何连接这些环节?从数据准备、训练供给、模型发布到知识更新,可以看清不同数据服务如何协同,以及共享底座怎样保留各自的运行节奏,接下来我们来探讨探讨!
一、数据准备:统一入口衔接存量数据与AI工作集
AI数据链路通常从图片、视频、文档、日志与业务结果汇聚开始。资料经清洗、标注和版本发布成为训练输入,训练持续读取样本并保存状态,产出的权重进入模型仓库,供推理服务发布、扩容与回退使用。RAG在原文之外生成向量和索引,查询时再回到原文与权限范围。任务结束后,训练集、模型和历史资料进入分层或归档,等待下一次复用。
深信服aStor统一存储提供块、文件、对象和向量四类服务,同时承载传统业务与AI创新。对于分散在适配NAS或对象存储中的资料,可先同步元数据建立统一入口,再按任务检索、预热和读取工作集。只读加速场景保留源端为主数据源;需要接管写入时,则收敛到统一存储入口并安排异步回刷。明确主写关系后,多阶段使用才能围绕同一份有效数据展开。
二、训练供给:元数据与并行访问减少算力等待
训练任务会反复扫描数据集。连续样本关注有效吞吐,大量图片或碎小文件更依赖目录扫描、元数据并发和打开关闭效率,多客户端并发又会形成热点。Checkpoint通常在特定时间集中写入,如果与训练读取、数据导入和后台保护争用资源,就可能让计算节点等待。评估训练链路时,需要分别记录冷态与重复读取、首轮加载、持续供数、尾部等待和状态保存,并同步观察网络、客户端和CPU处理。
针对这些差异,深信服aStor统一存储以多活元数据服务与目录分片分散小文件查找、创建和遍历压力,pNFS让兼容客户端获取布局后直接访问数据节点,NFS over RDMA在匹配网络中减少协议栈与复制开销。前者改善“找到样本”的路径,后两者改善“把样本送到计算端”的路径。全闪性能资源再与训练读取、数据导入和Checkpoint写入窗口共同规划,使连续供数与阶段性写回各有资源安排。
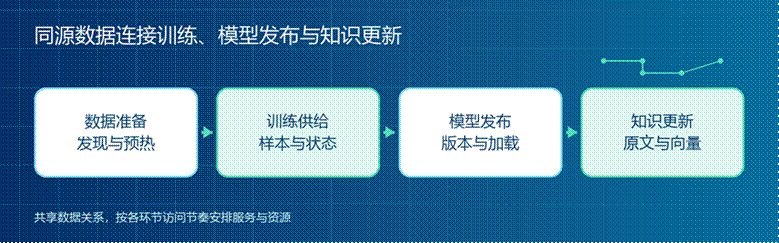
图1 AI数据从准备到训练、模型发布及知识更新的协同路径
三、模型发布:提前预热衔接集中加载与版本切换
推理服务的存储压力常集中在模型发布、实例启动、弹性扩容和版本切换窗口。模型权重、配置与依赖需要对应同一发布版本,回退时也要重新读取正确资料。模型加载关注文件大小、并发实例和冷热状态;运行中的逐Token响应则还依赖显存、计算框架与应用逻辑。因而模型供给与运行时缓存应分开规划,才能把存储资源用在实际访问路径上。
深信服aStor统一存储以文件或对象服务承接模型仓库,将即将发布的模型提前预热至性能层,使启动窗口尽量读取已准备的数据。旧模型按保留策略转入容量层,保留回退所需版本。共用底座时,可将在线模型库与批量训练数据分配到不同资源范围,并错开大批量导入与发布窗口,让共享资料与业务节奏相互兼容。
四、知识更新:原文、向量与变更通知协同
RAG首先要能够找到正确资料,再把相关内容交给模型。深信服aStor统一存储的向量桶与对象服务共享底座,通过原文标识、版本及检索元数据建立关联;查询返回候选后,上层应用据此回到原文,并完成访问鉴权。原文和向量作为相互关联的独立资源管理,可以让知识来源更易追踪,也便于围绕同一数据体系安排保留和更新。
资料创建、修改或删除后,文件与对象事件通知可异步把变化传给下游系统,由知识流水线完成切分、向量化和索引更新。持久化通知按至少一次投递处理,下游以事件标识去重,并协调原文撤权与旧向量清理。这条链路将“存储发现变化”与“应用更新知识”连接起来,支撑RAG和Agent持续使用有来源、可回溯的数据,而非每次从头重建整库。
五、多项目协作:对象数据分支减少重复副本
多个训练或知识项目使用同源资料时,正式数据与待处理数据应有清晰区分。深信服aStor统一存储的数据分支管理可在普通对象桶和目录桶中建立候选分支,修改后提交确定状态,经审阅合并发布;未变化的数据引用得以复用。训练任务记录相应版本,知识更新记录原文与派生索引关系,既便于协作,也能减少仅为区分实验而复制整套数据的做法。
分支负责固定存储中的数据状态,外部索引与应用配置按发布流程一起更新。冷热资源则跟随任务阶段安排:正在反复读取的样本、待加载的模型与高频原文进入性能层,旧模型、低频样本和历史资料进入容量层。统一底座由此连接准备、使用、发布和沉淀,而不要求所有任务采用同一种协议或介质。
六、实践验证:深信服aStor统一存储减少采集与训练间的中转
菲特(天津)检测技术有限公司的工业检测业务需要完成样本采集、标注与训练。采用深信服aStor统一存储后,项目以3台设备提供500TB存储,通过CIFS与NFS互通连接Windows标注和Linux训练,减少先从NAS复制到GPU本地SSD再开工的环节,并结合快照、审计和故障重建保护训练数据。
这种实践对应的是跨环节共享数据的建设方法:先把重复搬运最多的一段打通,再向模型资料和知识原文的统一管理延伸。后续增加推理或RAG任务时,可沿用已形成的数据入口、归属和容量规划,同时为新任务配置匹配的访问服务与运行资源。
总结
AI训练、模型推理与RAG的访问节奏各不相同,但可以围绕共享且可追溯的数据关系持续演进。从元数据准备到工作集供给,再到模型发布与知识更新,连贯的数据路径能够减少跨系统交接。深信服aStor统一存储以四类数据服务、并行访问、统一视图、数据分支及向量同源管理连接这一过程,为企业扩展多模型、多团队的AI应用提供共同的数据基础设施!
关于我们
扫码获取一对一服务