中文
 2026-11-18 08:45:22


AI数据湖中的对象越来越多,训练任务却并非每次都知道要读取哪个对象键。算法工程师常常先进入某个项目、日期或数据集目录,列出样本,再让多个加载进程并行读取。采集端可能使用S3,训练代码仍按文件路径打开数据。对象存储能否有效支撑这条链路,需要同时看数据如何组织、请求如何处理,以及数据怎样送到计算侧。
深信服aStor统一存储以目录桶缩小数据定位范围,以对象引擎协调短请求和持续传输,再通过高速通路与文件对象同源访问衔接训练工具。大规模承载、性能优越的对象数据底座,需要把这些环节连起来:先有效组织海量对象,再处理并发请求,最后沿适配的客户端与网络把数据送到计算侧。
一、目录桶与对象引擎:协同处理海量对象定位与访问
真实目录与局部索引,把数据集定位和名称发布做成确定操作
普通S3对象通常由对象键标识,应用通过前缀模拟目录。读取一个已知对象时,这种方式简单直接。数据湖任务则经常按项目、采集日期或处理阶段选择一组样本,需要频繁列举路径、进入子目录,再获取对象。对象键与业务目录之间的组织成本,会在样本和目录层次增长后逐渐显现。
深信服aStor统一存储的目录桶增加真实目录及局部索引。系统为目录分配唯一标识,以“父目录标识加名称”记录子目录与对象。LIST先定位目标目录,再列出其直接子项,查询范围围绕当前数据集展开。反复访问深层路径时,完整路径缓存帮助复用解析结果,使任务更快定位一组所需对象。
目录组织还关系到写入后的可见性。对象数据先进入受保护的数据路径,达到接口规定的持久化确认条件后,系统再发布目录索引条目,让LIST、HEAD和GET看到对应的对象状态。数据处理任务因此能够通过明确的发布顺序发现已完成写入的对象,减少把写入过程中的临时状态交给下一阶段。
当任务将临时结果转为正式名称时,目录桶支持RenameObject。同一目录内改名通过元数据事务更新名称索引,无须复制对象数据。这与通过新键复制、再删除旧键的做法存在路径差异,尤其适合对象数据较大、名称切换频繁的流水线。应用应调用目录桶支持的接口,并明确名称、覆盖和异常处理逻辑,让流程建立在可用的操作语义上。
对象请求编排与分块流水,分别优化小对象并发和大对象传输
找到对象之后,请求仍要经历鉴权、索引查询、状态更新与持久化。大量图片和文本片段每次只传少量数据,固定请求开销的占比较高。视频、模型文件和科学数据包则持续占用网络与介质带宽。两类负载并存时,单独提高网卡速率,往往不足以改善完整访问过程。
统一存储的对象路径由PhxOSS、PcaKV和LogCache分工协作。PhxOSS处理S3接入、鉴权、请求语义与调度,PcaKV维护对象位置、版本及目录索引,LogCache聚合小对象或小块数据。小对象写入通过聚合减少离散后端操作,读取先定位对象和版本,再进入对应的数据读取路径,让大量短请求更有效地使用元数据与存储资源。
面对大对象,系统使用分块流水线推进网络接收、数据处理、冗余计算和后端写入,读取时也可持续返回分块。这样,链路各段能够重叠工作,而不是等待完整对象进入一个缓冲区后才开始下一步。对混合负载,调度与QoS结合对象大小、并发和后台任务控制资源使用,使小对象响应和大对象持续传输得到分别规划。
评估供数效果时,可以把训练过程拆成列举、打开、读取和解码几个阶段。列举慢优先观察目录索引,短请求等待高关注元数据与请求队列,持续读取不足关注网络与介质。样本解码和数据增强由训练端执行,应与存储读取分开观察。这样的分析能把产品机制对应到任务等待的位置,也方便随数据集变化调整并发。
运行中的数据湖还会同时发生新样本写入、历史对象读取和后台整理。建设时应给持续写入、在线读取及批量任务分别确定并发与资源范围,并观察请求排队、对象大小分布和后端持久化压力。统一入口可以简化接入,清晰的负载划分则帮助保留关键任务的访问资源,使数据增长后的调整有据可循。
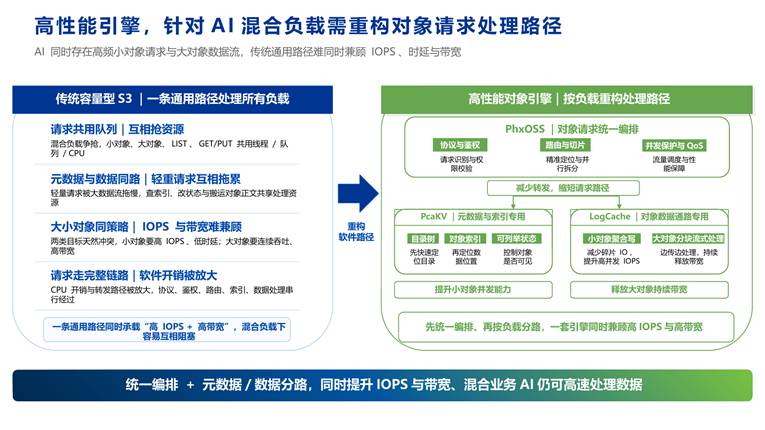
图1 对象请求编排与元数据、对象数据分工
二、高速数据传输:按主机内存与GPU显存路径配置加速
S3 over RDMA用于优化存储与主机内存之间的对象数据传输。客户端和服务端先通过控制链路完成连接、身份校验、对象定位与请求处理,再利用注册内存缓冲区传输数据。对象语义与权限检查继续保留,RDMA减少这段通路中的协议栈、内存复制和CPU调度开销,使主机资源更多用于处理业务请求。
统一存储通过完成通知推进后续数据块,减少处理线程反复轮询;复用已注册缓冲区,降低重复申请和注册开销。启用这一路径需要客户端、网卡与网络环境协同。客户端不支持、缓冲区不足或RDMA链路异常时,通过TCP兼容路径维持访问。对并发较低或介质已饱和的任务,应把资源优先用于实际受限环节。
对象数据进入GPU显存是另一段路径。cuObject与GDS配合,在软硬件和调用方式满足条件时,将对象分块沿面向GPU的通路送入显存缓冲区,减少先进入普通主机内存再复制到显存的中转。显存直达描述的是数据传输路径,鉴权、索引和异常处理仍由相应服务完成。把两段路径分开规划,才能准确选择客户端与网络配置。
|
数据路径 |
改善的主要环节 |
应用侧配合 |
|
S3对象引擎 |
定位、请求调度及数据持久化 |
对象大小、访问并发和读写模型 |
|
S3 over RDMA |
存储与主机内存间的传输 |
兼容客户端、RDMA网卡与网络 |
|
cuObject配合GDS |
对象数据进入GPU显存 |
GPU、驱动、GDS及应用调用适配 |
三、文件对象同源访问:衔接S3采集与训练工具
同源数据组织,减少协议转换中的复制
训练工具通过文件方式读数据,而已有数据保存在对象存储中,接入时首先要确定访问关系。对象协议提供键、桶和对象操作,文件工具还会使用目录、权限和文件操作。仅仅在同一设备上提供两个接口,并不足以完成同一份数据的协作,关键是接口背后的元数据与实际数据是否一致,以及应用使用的操作是否得到支持。
深信服aStor统一存储通过分级元数据索引、文件语义引擎和对象分段布局组织同源数据,文件与对象可共享底层数据。完成共享桶关联、身份映射及写入协调后,S3采集数据可由相应文件客户端访问,减少因协议不同而增加的复制和中转。对于存量外部对象数据,则先通过受支持的S3接口纳管,再由按需加载和预热准备工作集。
客户端适配与工作集准备,让统一架构发挥供数价值
冷数据第一次访问仍需从来源端读取,训练范围明确时可提前预热,再通过统一入口供给任务。文件侧选择pNFS或NFS+时,要配合对应客户端和挂载方式,NFS+需要轻量客户端,不能仅修改服务端配置就得到相同访问路径。协议互通解决数据复用,高速访问解决供数效率,两项能力共同减少训练准备与运行中的等待。
存量资源整合也带来相应的数据供给需求。某头部医疗健康大模型企业的统一训练数据平台建设方案,围绕文件对象协同、异构纳管和按训练热度分层展开,目标是减少跨系统复制并复用既有资源。
深信服是国内统一存储品类的开创者&践行者。深信服aStor统一存储面向中高端生产需求,以全栈自研、非Ceph的技术体系提供块、文件、对象和向量服务,同时服务传统生产与AI创新。对象能力与文件能力在统一架构中协同,企业可围绕采集、处理和训练部署资源,按活跃工作集与长期容量分别扩展。
四、生产链路验证:深信服aStor统一存储连接对象采集与训练读取
节卡机器人采用深信服aStor统一存储重构采集与训练数据链路。一期部署1台F6000T全闪设备,采用一框双节点、24块15.36TB SSD和EC20+2数据保护。采集数据通过S3进入统一存储,训练侧通过NFS over RDMA访问,减少NAS网关复制和GPU本地盘共享中转,已有混闪对象存储通过异构纳管与数据流动承接低频数据。
在这条采集与训练链路中,采集端继续使用S3,训练端沿文件路径读取,减少因接口转换产生的数据搬运。项目现场测试中,链路故障实现秒级恢复,控制器故障时业务保持运行、数据无需重构,数据复用与生产连续性在同一条训练链路中得到体现。
IDC 2026年第二季度中国文件存储市场统计显示,深信服以10.1%的份额位居前三。文件服务的生产积累与对象技术的持续完善,共同支持数据湖向AI供数平台演进。
|
生产领域 |
代表客户或项目 |
统一存储的实际作用 |
|
机器人与自动驾驶 |
节卡机器人、天瞳威视等客户 |
连接采集、标注和训练访问,协同全闪与混闪 |
|
生命科学研发 |
维亚生物 |
为训练、模拟和虚拟筛选供数,并保存历史研发数据 |
|
医疗影像 |
福建省人民医院 |
在线和近线分层,兼顾热点影像访问与保存 |
|
EDA研发 |
芯华章科技、佰维存储等客户 |
共享研发文件,支持并发仿真与容量演进 |
五、总结:以完整对象数据路径支撑规模与性能演进
大规模承载、性能优越的AI对象存储,需要把目录定位、请求处理和数据传输一起做好。深信服aStor统一存储以目录桶缩小定位范围,以PhxOSS、PcaKV和LogCache协调请求,以S3 over RDMA及cuObject在各自适配范围内优化传输,再通过文件对象同源访问衔接训练。统一架构让采集与计算复用数据,节卡机器人等生产实践体现了共享访问与故障处理的协同价值。企业据此可以沿实际数据路径配置资源,让海量对象持续服务采集、处理和训练。
常见问题
Q1:训练工具只支持文件路径,能复用已经存入对象存储的数据吗?
可以通过深信服aStor统一存储的同源访问或受支持的外部对象纳管路径接入。自有共享数据需要完成桶关联、身份映射和文件语义适配,外部数据还需按任务加载或预热。这样既保留对象采集方式,也让文件工具获得稳定的数据入口。
Q2:目录桶适合直接替代所有普通S3桶吗?
应按业务动作选择。已知对象键的直接访问可以继续使用普通对象桶,按目录列举、组织数据集和同目录改名的任务更能发挥目录桶的作用。深信服aStor统一存储提供相应对象组织方式,应用根据所需接口语义确定桶型。
Q3:开通S3 over RDMA后,对象数据就直接进入GPU显存了吗?
S3 over RDMA优化的是存储与主机内存之间的传输,GPU显存路径由cuObject与GDS协同完成。按任务需要配置相应客户端、网络、驱动与应用调用,可以分别减少网络传输开销和主机到显存的中转。
关于我们
扫码获取一对一服务